Thống kê mô tả là bảng đầu tiên hội đồng nhìn vào trong chương kết quả: nó cho biết dữ liệu có sạch không, người trả lời đánh giá từng câu hỏi ở mức nào và phân phối có xấp xỉ chuẩn để chạy các phép kiểm định tiếp theo hay không. Bài viết hướng dẫn cách chạy thống kê mô tả trên ResearchSTAT và cách đọc từng cột của bảng Descriptive Statistics, kèm câu mẫu để đưa vào luận văn.
Khi nào cần chạy thống kê mô tả?
- Ngay sau khi làm sạch, mã hóa dữ liệu: để phát hiện giá trị nhập sai (ví dụ 6 hoặc 0 với thang Likert 1-5).
- Trước Cronbach's Alpha và EFA: để biết câu hỏi nào có ý kiến quá đồng thuận (độ lệch chuẩn gần 0) hoặc lệch mạnh.
- Khi viết phần “Thực trạng”: mô tả mức đánh giá của người trả lời với từng thang đo, từng câu hỏi.
Các bước thực hiện trên ResearchSTAT
- Vào Dữ liệu, tải file Excel, CSV hoặc .sav và chọn bộ dữ liệu ở thanh trên.
- Mở Phân tích → Thống kê mô tả. Ô Gợi ý cho bộ dữ liệu đề xuất sẵn “Tất cả biến quan sát” theo mã thang đo (TC1, TC2...); bấm Áp dụng.
- Bấm Kiểm tra để hệ thống cảnh báo biến không phù hợp (biến chữ, biến hằng), rồi bấm Chạy phân tích.
- Chọn thuật ngữ kết quả: Tiếng Anh (đúng như SPSS) hoặc Tiếng Việt; xuất PDF, Word, Excel ở khung Tải báo cáo.
Bảng kết quả Descriptive Statistics
| N | Minimum | Maximum | Mean | Std. Deviation | Skewness | Kurtosis | |
|---|---|---|---|---|---|---|---|
| STC1 | 400 | 1 | 5 | 3.82 | .894 | -.612 | .214 |
| STC2 | 400 | 1 | 5 | 3.67 | .951 | -.487 | -.135 |
| STC3 | 398 | 1 | 5 | 3.85 | .872 | -.703 | .391 |
| STC4 | 400 | 2 | 5 | 3.61 | .918 | -.358 | -.427 |
| Valid N (listwise) | 398 |
Cột N và dòng Valid N (listwise)
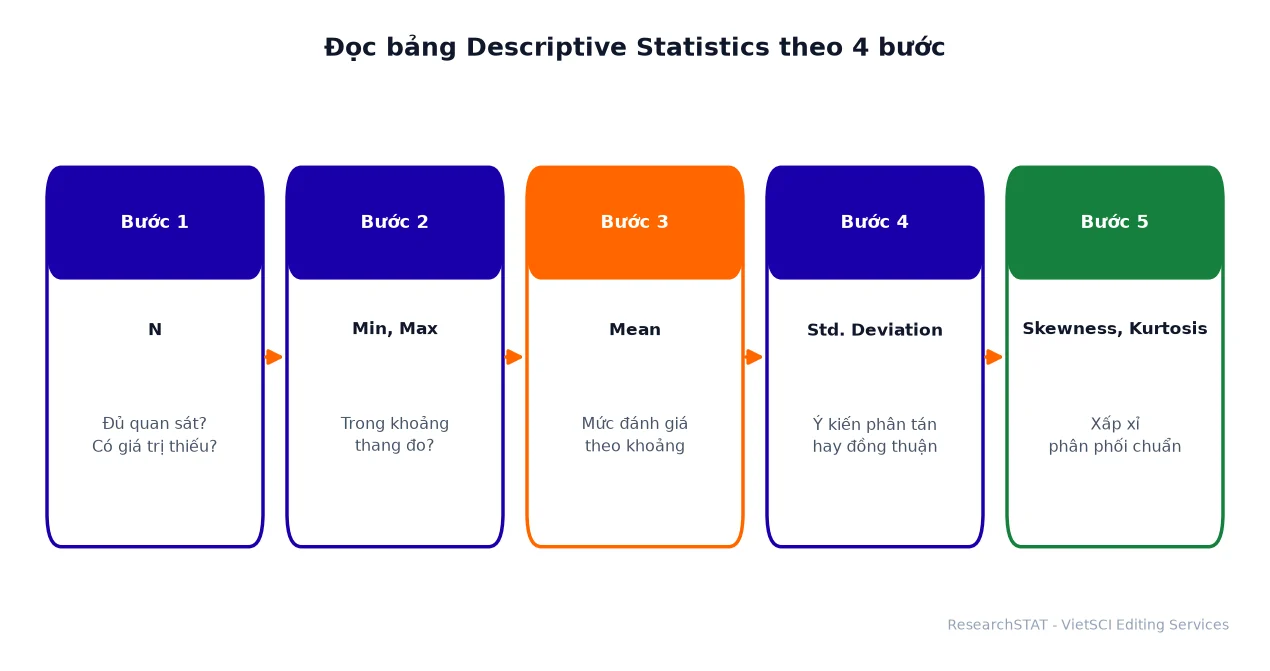
N là số quan sát hợp lệ của từng biến. STC3 chỉ có 398 nghĩa là 2 người bỏ trống câu này. Dòng Valid N (listwise) là số người trả lời đủ mọi biến trong bảng; đây là cỡ mẫu thực tế nếu các phép phân tích sau loại quan sát thiếu theo danh sách. Khi N chênh lệch nhiều giữa các biến, cần giải thích cách xử lý giá trị thiếu trong phần phương pháp.
Cột Minimum, Maximum
Giá trị nhỏ nhất, lớn nhất phải nằm trong khoảng của thang đo. Với Likert 5 mức, Max = 6 hoặc Min = 0 là dấu hiệu nhập liệu sai hoặc mã “không trả lời” (ví dụ 9, 99) chưa được khai báo là giá trị thiếu. Trên ResearchSTAT, khai báo mã thiếu ở tab Biến của mục Dữ liệu rồi chạy lại.
Cột Mean: mức đánh giá trung bình
Với thang Likert k mức, giá trị khoảng cách = (k - 1)/k. Thang 5 mức có khoảng cách 0,8 nên thường diễn giải: 1,00-1,80 rất thấp; 1,81-2,60 thấp; 2,61-3,40 trung bình; 3,41-4,20 cao; 4,21-5,00 rất cao. Trong ví dụ, bốn câu của thang đo Sự tin cậy có trung bình 3,61-3,85, tức ở mức cao.
Cột Std. Deviation
Độ lệch chuẩn cho biết ý kiến phân tán đến đâu. Giá trị khoảng 0,8-1,0 với Likert 5 mức là bình thường. Độ lệch chuẩn rất nhỏ (dưới 0,4) nghĩa là gần như mọi người chọn cùng một mức; câu hỏi đó ít phân biệt được người trả lời và thường có tương quan biến-tổng thấp ở bước Cronbach's Alpha.
Cột Skewness và Kurtosis
Skewness âm (ví dụ -0,612) cho biết phân phối lệch về phía điểm cao, điều thường gặp khi người trả lời đánh giá tích cực. Theo Kline (2016), |Skewness| < 3 và |Kurtosis| < 10 được xem là chấp nhận được cho ước lượng ML; nhiều tài liệu dùng ngưỡng chặt hơn |Skewness| < 2 và |Kurtosis| < 7. Bảng ví dụ đều đạt nên dữ liệu xấp xỉ chuẩn.
Mẫu viết kết quả
Kết quả thống kê mô tả cho thấy các biến quan sát của thang đo Sự tin cậy có giá trị trung bình từ 3,61 (STC4) đến 3,85 (STC3), thuộc mức đánh giá cao; độ lệch chuẩn từ 0,872 đến 0,951. Hệ số Skewness từ -0,703 đến -0,358 và Kurtosis từ -0,427 đến 0,391 đều nằm trong ngưỡng ±2, cho thấy dữ liệu xấp xỉ phân phối chuẩn.
Câu hỏi thường gặp
Nên báo cáo thống kê mô tả cho từng câu hỏi hay cho từng thang đo?
Cả hai đều phổ biến. Phần thực trạng thường trình bày theo từng câu hỏi; phần mô tả biến nghiên cứu dùng biến đại diện (trung bình các câu của thang đo). ResearchSTAT gợi ý cả hai lựa chọn trong ô Gợi ý.
Mean để dấu phẩy hay dấu chấm?
Văn bản tiếng Việt dùng dấu phẩy thập phân (3,82). Khi xuất Word/PDF, chọn “Phẩy (3,14)” ở khung Tải báo cáo; bảng tiếng Anh kiểu SPSS giữ dấu chấm.
Có cần làm tròn bao nhiêu chữ số?
Mean và độ lệch chuẩn thường để 2-3 chữ số thập phân, thống nhất trong toàn bộ luận văn.
Xem thêm: cách đọc kết quả Cronbach's Alpha - bước tiếp theo sau thống kê mô tả.