Trước khi có dữ liệu khảo sát thật, người học thường cần một bộ dữ liệu "có cấu trúc đúng" để luyện quy trình: kiểm định Cronbach's Alpha, EFA, CFA, SEM, phân tích trung gian và điều tiết. Chức năng Tạo dữ liệu mô phỏng của ResearchSTAT sinh bộ dữ liệu khảo sát hoàn chỉnh từ chính mô hình nghiên cứu bạn khai báo, rồi tự chạy lại toàn bộ quy trình phân tích để bạn đối chiếu kết quả với tham số đã đặt.
Dữ liệu mô phỏng luôn gắn nhãn MÔ PHỎNG, mọi báo cáo từ dữ liệu này đều có cảnh báo. Nghiêm cấm trình bày dữ liệu hoặc kết quả mô phỏng như dữ liệu khảo sát thật (Quy định liêm chính học thuật).
Ba cách thiết kế mô hình
- Mẫu có sẵn: mô hình chuẩn cho SEM, mô hình trung gian theo TAM, mô hình có biến điều tiết và mô hình "sát thực tế khảo sát" có câu đảo, giá trị thiếu, người trả lời cẩu thả.
- Từ tên đề tài: nhập tên đề tài, hệ thống chọn mô hình lý thuyết phù hợp trong thư viện (TAM, TPB, UTAUT, SERVQUAL, gắn kết nhân viên, giá trị thương hiệu, kết quả học tập) và đọc các cụm như "vai trò trung gian của…", "vai trò điều tiết của…" để thêm đúng biến.
- Từ ảnh mô hình: tải ảnh sơ đồ khái niệm, AI đọc các khái niệm và mũi tên giả thuyết (tính năng AI, chỉ chạy khi bạn đồng ý gửi ảnh tới nhà cung cấp AI).
Dù dùng cách nào, mô hình chỉ là điểm khởi đầu: bạn kiểm tra lại tên khái niệm, số câu hỏi, hệ số tác động theo khung lý thuyết của mình trước khi tạo dữ liệu.
Đủ các loại biến trong nghiên cứu định lượng
Mỗi khái niệm được gán một vai trò, và sơ đồ mô hình tự vẽ lại theo từng thay đổi:
- Biến độc lập: khái niệm chỉ phát tác động.
- Biến trung gian: vừa nhận vừa phát tác động (X → M → Y), để luyện phân tích tác động gián tiếp.
- Biến điều tiết: làm mạnh lên hoặc yếu đi một giả thuyết X → Y. Dữ liệu chứa đúng hiệu ứng tương tác X × M, và mô hình PLS-SEM được dựng sẵn biến tương tác theo cách tiếp cận hai giai đoạn.
- Biến phụ thuộc: khái niệm kết quả cuối của mô hình.
- Biến kiểm soát và nhân khẩu học: giới tính, nhóm tuổi, thu nhập… có thể tạo chênh lệch nhóm hoặc tương quan thật với một khái niệm.
Dữ liệu được sinh ra như thế nào?
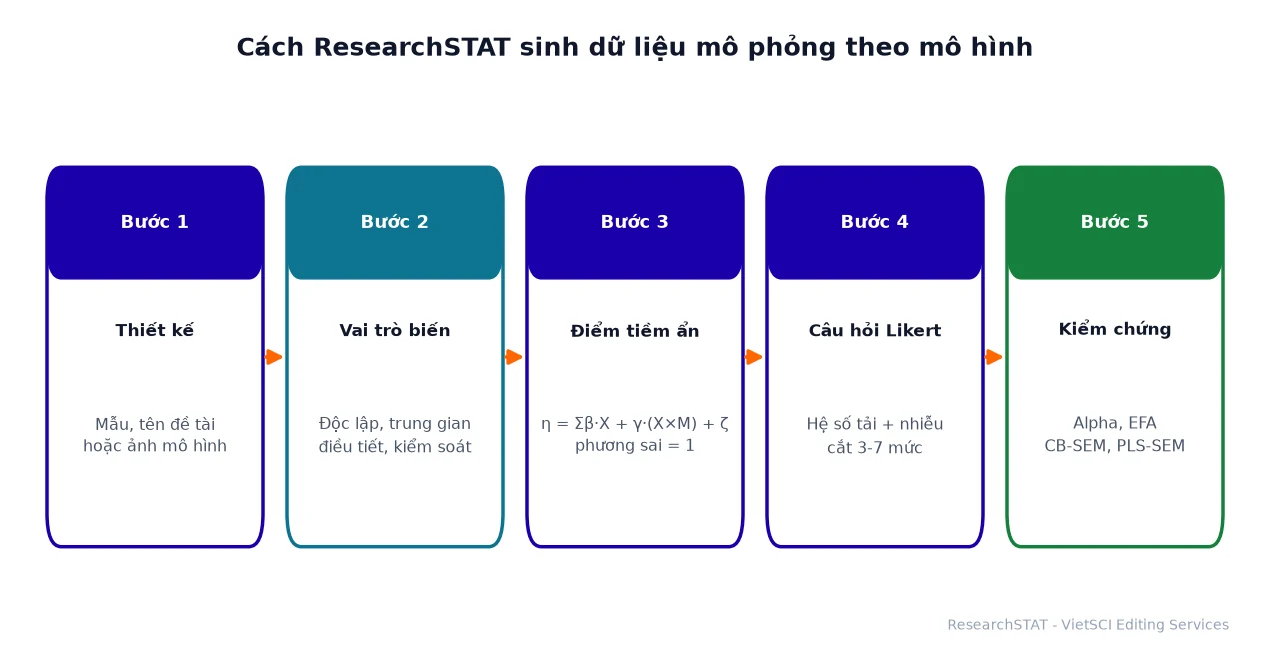
Mỗi người trả lời có một điểm tiềm ẩn cho từng khái niệm. Biến ngoại sinh được rút từ phân phối chuẩn với hệ số tương quan bạn khai báo. Biến nội sinh bằng tổng các tác động β × nguyên nhân, cộng tác động tương tác γ × (X × M) nếu có biến điều tiết, cộng sai số; phương sai sai số được tính để tổng phương sai đúng bằng 1, nhờ đó β là hệ số chuẩn hóa và R² tổng thể được công bố chính xác. Sau đó mỗi câu hỏi bằng hệ số tải × điểm tiềm ẩn cộng nhiễu, rồi được cắt thành thang Likert 3 đến 7 mức.
Vì dữ liệu đi qua sai số lấy mẫu, sai số đo lường và bước rời rạc hóa Likert, kết quả ước lượng sẽ gần nhưng không bằng tham số tổng thể, đúng như với dữ liệu thật. Đây chính là điều giúp bạn hiểu ý nghĩa của sai số chuẩn, khoảng tin cậy và cỡ mẫu.
Tự kiểm chứng bằng toàn bộ quy trình phân tích
Khi bấm "Tạo dữ liệu và chạy toàn bộ quy trình", hệ thống tự đảo mã câu nghịch, lưu sẵn mô hình CB-SEM và PLS-SEM có sơ đồ, rồi chạy lần lượt Cronbach's Alpha cho từng thang đo, EFA, CFA/CB-SEM và PLS-SEM. Mỗi bước hiện các tiêu chí đạt/chưa đạt (Alpha ≥ 0,7, KMO ≥ 0,6, CFI, RMSEA, SRMR, CR, AVE, ý nghĩa của đường dẫn) để bạn tập đọc kết quả.
- 1Tải file ExcelBảng hỏi khảo sát
- 2Mã hóa tự độngLikert, nhãn biến, nhóm thang đo
- 3Phân tíchAlpha, EFA, hồi quy, SEM
- 4Báo cáoWord, Excel, PDF, .sav, .spv
Giới hạn theo gói
Gói Miễn phí tạo được dữ liệu mô phỏng nhỏ (n < 20) để làm quen giao diện; dữ liệu mô phỏng đầy đủ cỡ mẫu cho SEM và quy trình SEM tự động có trong gói trả phí. Mỗi bước phân tích trong quy trình tính là một lượt phân tích của gói. Xem trang giới thiệu mô phỏng dữ liệu hoặc bắt đầu tại Ứng dụng → Dữ liệu mô phỏng.