Với phần lớn luận văn định lượng, khâu tốn thời gian nhất không phải là đọc kết quả mà là chuẩn bị dữ liệu: chuyển câu trả lời "Đồng ý", "Hoàn toàn đồng ý" thành số, đặt tên biến, gom câu hỏi vào đúng thang đo, loại các cột họ tên, email rồi mới chạy lần lượt thống kê mô tả, Cronbach's Alpha, EFA, tương quan, hồi quy. Chức năng Phân tích tự động của ResearchSTAT gom toàn bộ chuỗi việc đó vào một lần tải file, và trả về báo cáo tổng hợp trình bày theo bố cục bảng SPSS quen thuộc.
Phân tích tự động làm gì với file khảo sát của bạn?
Sau khi bạn tải file lên, hệ thống đọc từng cột và quyết định cách mã hóa. Mọi quyết định đều hiển thị trong bảng mã hóa để bạn kiểm tra trước khi chạy, không có bước nào bị ẩn.
- Câu trả lời Likert dạng chữ được chuyển thành số, kể cả câu song ngữ như "Đồng ý / Agree". Thang 3, 4, 5, 6 hoặc 7 mức đều được nhận diện; thang 4 mức không có "Trung lập" được đánh số đúng 1-4.
- Nhãn giá trị lấy nguyên văn từ câu trả lời của người tham gia, nên bảng tần suất hiển thị đúng chữ trong bảng hỏi.
- Câu hỏi được gom thành thang đo dựa trên mã đầu câu (TC1, TC2… hoặc SAV_1) hoặc dạng lưới "Nhóm [câu hỏi]" của Google Forms.
- Cột định danh bị loại (họ tên, email, số điện thoại, dấu thời gian) để bảo vệ dữ liệu cá nhân; cột chỉ có một giá trị (câu sàng lọc) cũng được loại vì không có biến thiên.
- Biến nhân khẩu học (giới tính, nhóm tuổi, trình độ…) được mã hóa có nhãn và sắp theo thứ tự hợp lý.
Từ bảng mã hóa đến báo cáo tổng hợp
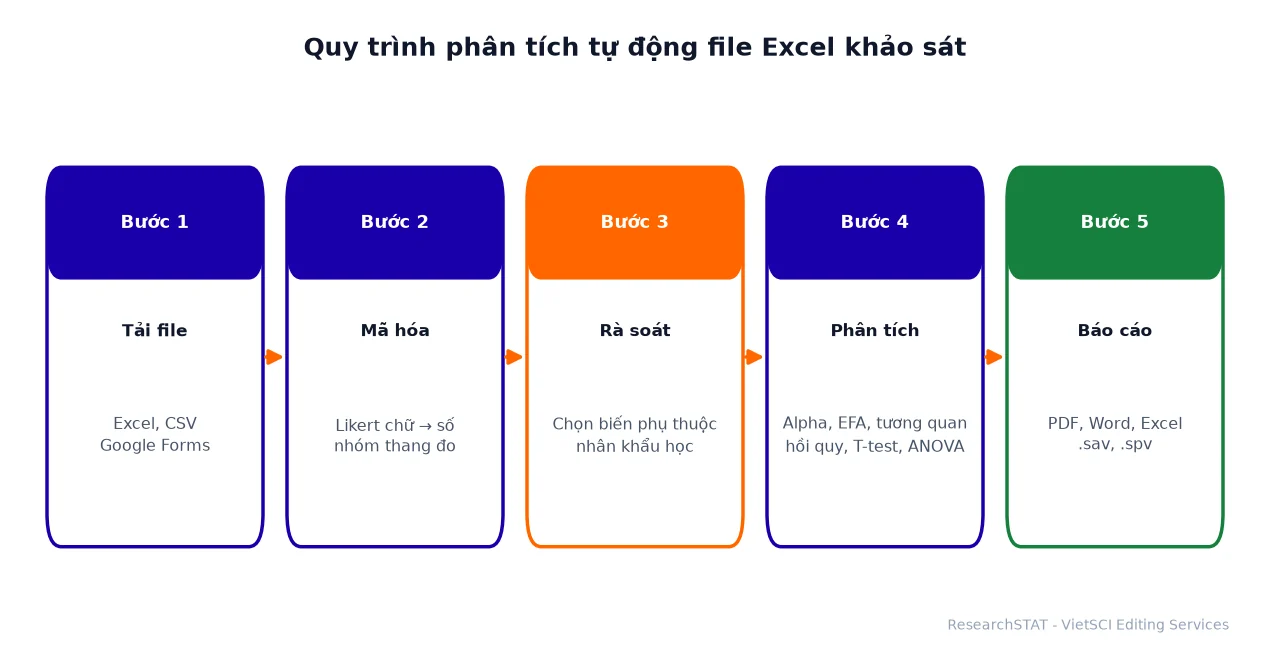
Ở bước rà soát, bạn chọn thang đo đưa vào phân tích, biến phụ thuộc của mô hình hồi quy và các biến nhân khẩu học dùng để so sánh nhóm. Hệ thống gợi ý sẵn biến phụ thuộc dựa trên tên thang đo, bạn chỉ cần xác nhận. Bạn cũng chọn ngôn ngữ của file kết quả: tiếng Anh (dùng đúng thuật ngữ trong bảng SPSS) hoặc tiếng Việt, và giá trị kiểm định của One-Sample T-test được gợi ý theo số mức của thang Likert.
Báo cáo tổng hợp gồm các phần theo đúng trình tự một chương kết quả nghiên cứu:
- Descriptive: bảng tần số, phần trăm cho biến nhân khẩu học và thống kê mô tả cho các biến quan sát.
- Cronbach's Alpha: Reliability Statistics, Item-Total Statistics cho từng thang đo.
- EFA cho nhóm biến độc lập và biến phụ thuộc: KMO và Bartlett, Total Variance Explained, ma trận xoay.
- Harman: kiểm tra sai lệch do phương pháp chung.
- Correlation: ma trận tương quan Pearson giữa các biến đại diện.
- Regression: Model Summary, ANOVA, Coefficients, chẩn đoán đa cộng tuyến, kèm ba biểu đồ Histogram (có Mean, Std. Dev., N), Normal P-P Plot và Scatterplot.
- One Sample T-test và One Way ANOVA theo nhóm nhân khẩu học, có kiểm định Levene, Welch và Brown-Forsythe.
| R | R² | R² hiệu chỉnh | Durbin-Watson |
|---|---|---|---|
| 0,712 | 0,507 | 0,503 | 1,946 |
Kết quả có giống hệt SPSS không?
Bảng kết quả được trình bày theo cấu trúc bảng SPSS để bạn dễ đối chiếu và đưa vào luận văn, nhưng được tính bởi bộ máy thống kê độc lập của ResearchSTAT (NumPy, SciPy, statsmodels), không phải do IBM SPSS Statistics tạo ra. Các công thức được kiểm thử đối chiếu với kết quả tham chiếu, ví dụ khoảng tin cậy của Cohen's d khớp với bảng SPSS mẫu đến 6 chữ số thập phân. Mỗi file xuất ra đều ghi rõ nguồn tính toán; khi viết phần phương pháp, bạn nên ghi đúng công cụ đã dùng theo Quy định liêm chính học thuật.
Mẹo chuẩn bị file để mã hóa chính xác
- Đặt mã thang đo ở đầu câu hỏi trong bảng hỏi, ví dụ "TC1. Nhân viên phục vụ đúng hẹn". Mã gồm tối thiểu 3 ký tự sau khi hệ thống chuẩn hóa (TC → TCC).
- Giữ nguyên một dòng tiêu đề, mỗi người trả lời một dòng; không gộp ô, không thêm dòng tổng.
- Câu hỏi nghịch nên được ghi chú để đảo mã trong mục Dữ liệu trước khi tính độ tin cậy.
- Ẩn danh hóa dữ liệu trước khi tải lên nếu có thể, dù hệ thống đã tự loại các cột định danh.
Dùng thử ngay với gói Miễn phí
Gói Miễn phí có 3 lượt phân tích mỗi ngày, tối đa 10 lượt, bao gồm cả phân tích tự động, và xuất báo cáo PDF. Xuất Word, Excel, .sav, .spv có trong gói Tiêu chuẩn và Chuyên nghiệp. Xem chi tiết tại Bảng giá hoặc bắt đầu tại Ứng dụng → Phân tích tự động.