Hồi quy tuyến tính bội là kỹ thuật kiểm định giả thuyết phổ biến nhất trong luận văn kinh tế, quản trị, giáo dục và y tế công cộng tại Việt Nam. Chạy hồi quy chỉ mất vài giây, nhưng để kết quả đáng tin cậy, bạn cần kiểm tra các giả định hồi quy, đánh giá đa cộng tuyến bằng VIF, xem Durbin-Watson, rồi diễn giải và trình bày đúng chuẩn. Bài viết đi qua toàn bộ quy trình, từ chuẩn bị biến đại diện đến cách viết kết quả hồi quy trong chương 4.
Chuẩn bị dữ liệu cho hồi quy
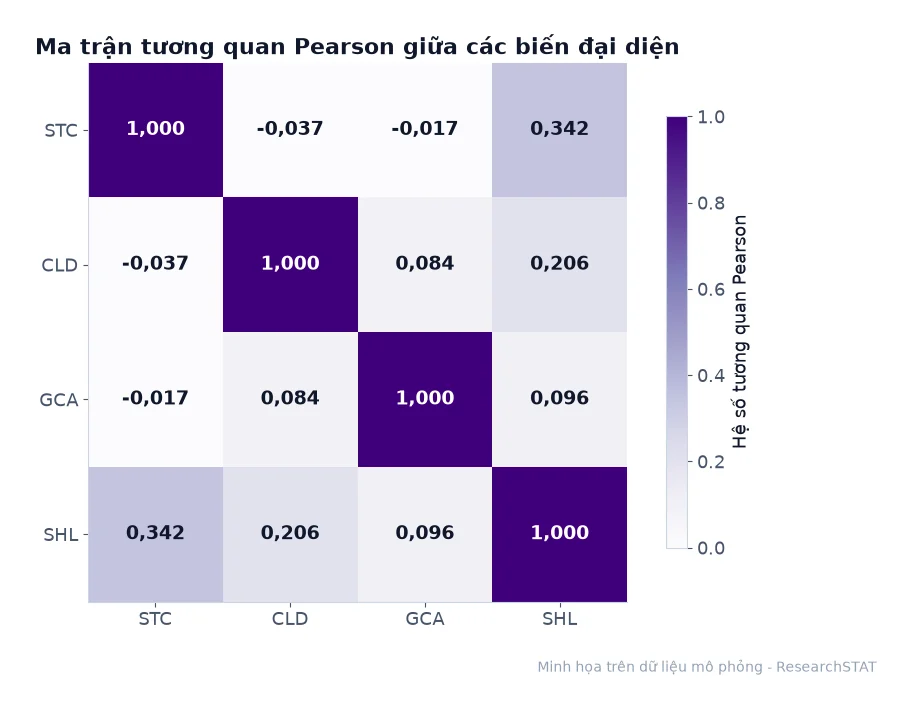
Trong nghiên cứu dùng thang đo Likert, mỗi khái niệm thường được đại diện bằng điểm trung bình của các biến quan sát còn lại sau Cronbach's Alpha và EFA. Ví dụ, biến đại diện STC là trung bình của STC1 - STC4. Trước khi hồi quy, hãy xem ma trận tương quan: biến phụ thuộc nên tương quan có ý nghĩa với các biến độc lập; các biến độc lập tương quan quá cao với nhau (trên 0,8) là dấu hiệu sớm của đa cộng tuyến.
Đọc kết quả hồi quy: R², F và hệ số
Kết quả hồi quy thường gồm ba bảng. Bảng tóm tắt mô hình cho R², R² hiệu chỉnh (tỷ lệ biến thiên của biến phụ thuộc được giải thích, đã điều chỉnh theo số biến) và Durbin-Watson. Bảng ANOVA cho kiểm định F: nếu p < 0,05, mô hình có ít nhất một biến độc lập giải thích được biến phụ thuộc. Bảng hệ số cho hệ số chưa chuẩn hóa B, sai số chuẩn, hệ số chuẩn hóa β, t, p và VIF của từng biến.
- B dùng để viết phương trình hồi quy và diễn giải theo đơn vị gốc: khi X tăng 1 đơn vị, Y thay đổi B đơn vị, giữ các biến khác không đổi.
- β dùng để so sánh mức độ tác động tương đối giữa các biến độc lập.
- p < 0,05: hệ số có ý nghĩa thống kê, giả thuyết tương ứng được ủng hộ nếu dấu của hệ số đúng kỳ vọng.
Kiểm tra các giả định của hồi quy tuyến tính
Ước lượng bình phương tối thiểu (OLS) cho kết quả đáng tin khi các giả định sau được thỏa mãn ở mức chấp nhận được. Mỗi giả định có công cụ kiểm tra riêng:
| Giả định | Cách kiểm tra | Dấu hiệu vi phạm |
|---|---|---|
| Quan hệ tuyến tính | Đồ thị phần dư theo giá trị dự báo | Phần dư có dạng cong |
| Phần dư phân phối chuẩn | Histogram, Q-Q plot | Lệch mạnh, đuôi dày |
| Phương sai không đổi | Đồ thị phần dư theo giá trị dự báo | Hình phễu loe rộng |
| Độc lập của phần dư | Durbin-Watson | Giá trị xa 2 (ngoài 1,5 - 2,5) |
| Không đa cộng tuyến | VIF, tolerance | VIF cao (xem bên dưới) |
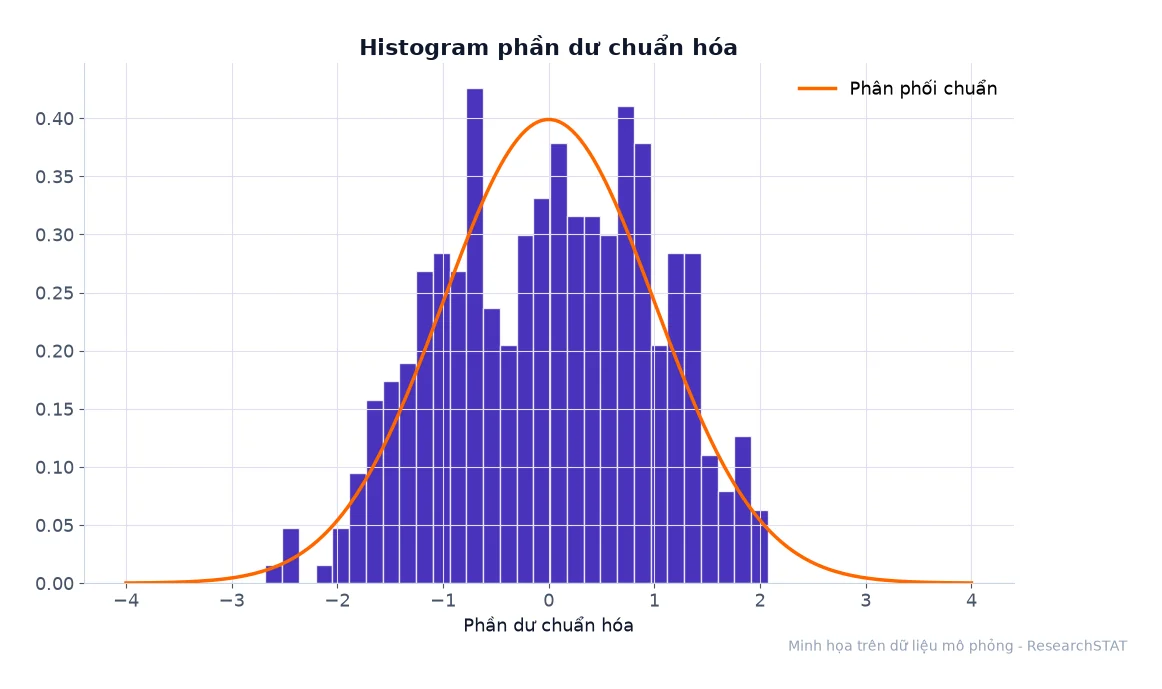
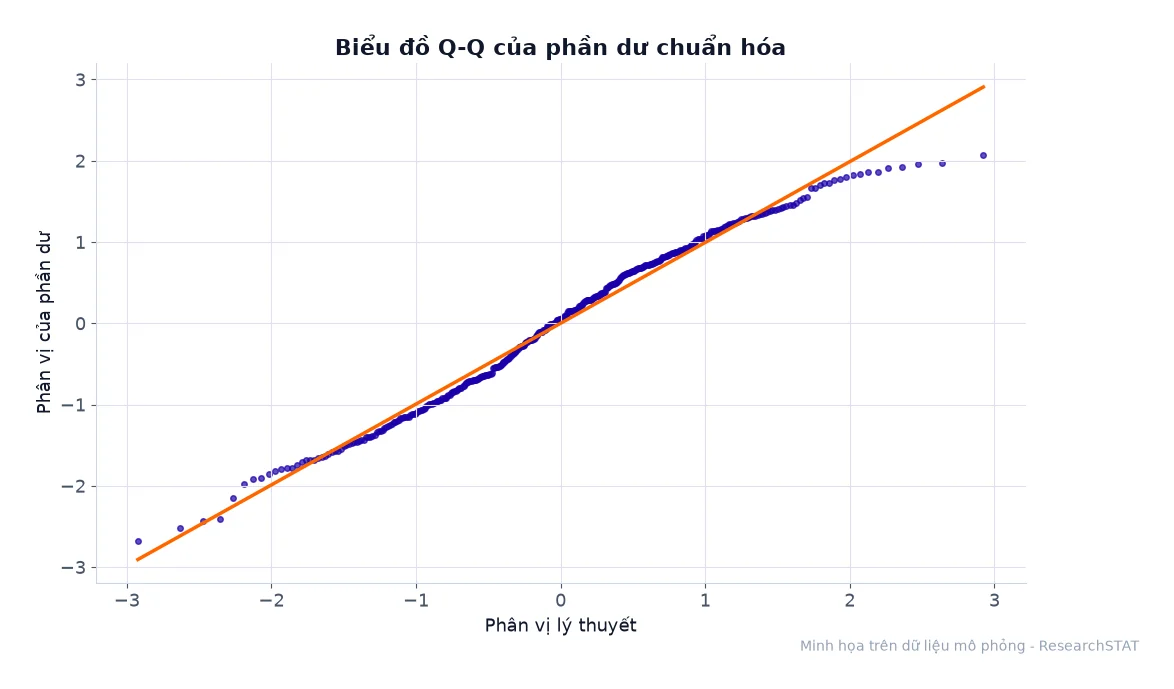
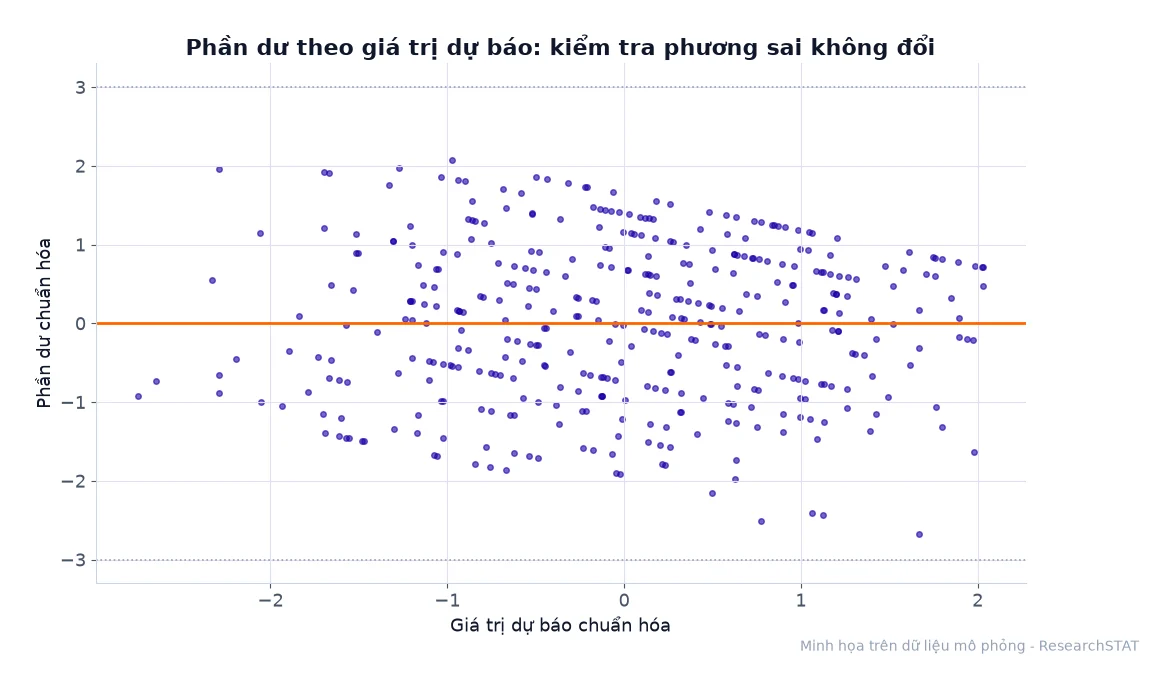
Với cỡ mẫu lớn, vi phạm nhẹ giả định phân phối chuẩn của phần dư thường không ảnh hưởng nhiều đến suy luận, nhờ định lý giới hạn trung tâm. Ngược lại, phương sai thay đổi và quan hệ phi tuyến cần được xử lý, chẳng hạn bằng sai số chuẩn vững (robust standard errors), biến đổi biến hoặc thêm số hạng bậc hai.
Đa cộng tuyến và hệ số VIF
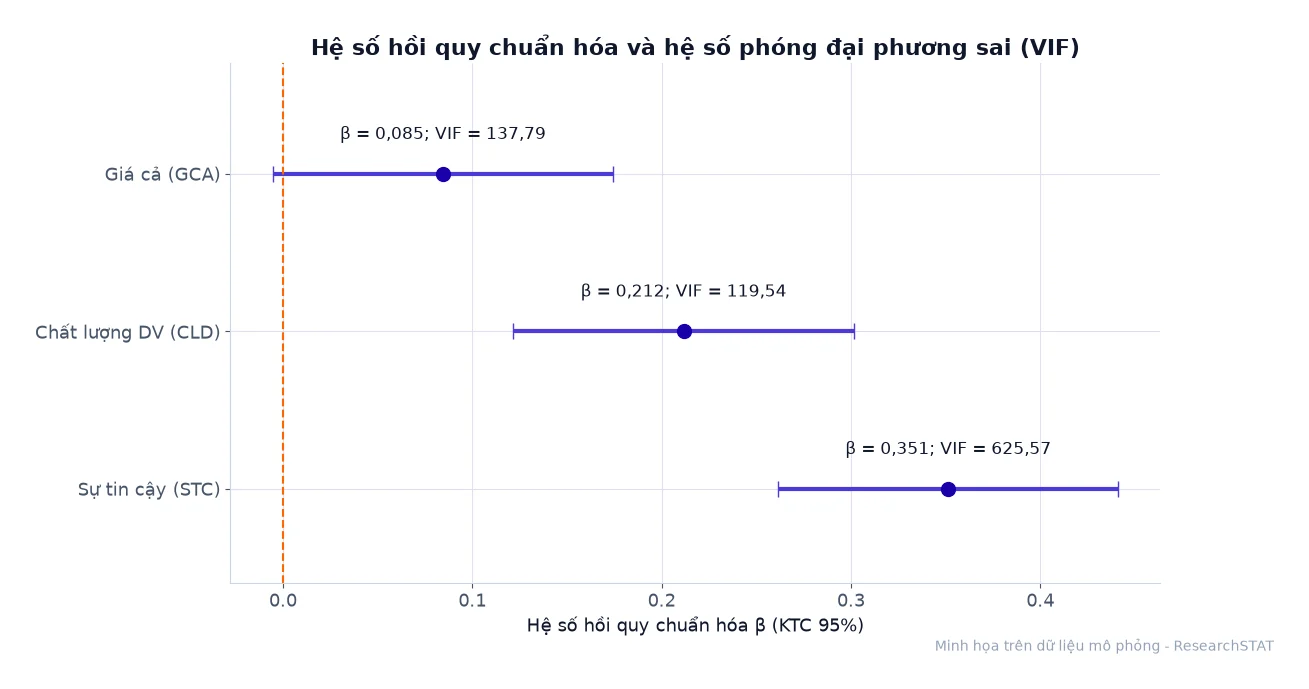
Đa cộng tuyến xảy ra khi các biến độc lập tương quan mạnh với nhau, làm sai số chuẩn phình to, hệ số không ổn định và có thể đổi dấu. Hệ số phóng đại phương sai (VIF) đo mức độ này cho từng biến. Ngưỡng truyền thống là VIF < 10 (Hair và cộng sự, 2019), nhưng nhiều tác giả khuyến nghị chặt hơn: VIF < 5, thậm chí < 3 với PLS-SEM. Trong luận văn, nếu VIF của mọi biến dưới 2 - 3, có thể kết luận đa cộng tuyến không đáng kể. Khi VIF cao, hãy xem lại tính phân biệt của các khái niệm, gộp hoặc loại biến trùng lặp thay vì loại máy móc.
Cách viết kết quả hồi quy trong luận văn
Một đoạn kết quả đầy đủ cần nêu: độ phù hợp của mô hình (R² hiệu chỉnh, F, p), kết quả kiểm tra giả định, hệ số từng biến (B hoặc β, p), kết luận giả thuyết và phương trình hồi quy. Ví dụ minh họa cách viết:
Mô hình hồi quy có R² hiệu chỉnh = 0,412, cho thấy ba biến độc lập giải thích 41,2% sự biến thiên của Sự hài lòng; kiểm định F có ý nghĩa (F(3; 396) = 94,3; p < 0,001). Hệ số Durbin-Watson = 1,94 và VIF của các biến từ 1,12 đến 1,35 cho thấy không có tự tương quan và đa cộng tuyến đáng kể. Cả ba biến đều tác động dương và có ý nghĩa thống kê đến Sự hài lòng, trong đó Sự tin cậy có tác động mạnh nhất (β = 0,352; p < 0,001), tiếp theo là Chất lượng dịch vụ (β = 0,301; p < 0,001) và Giá cả (β = 0,186; p < 0,001). Do đó các giả thuyết H1, H2, H3 được ủng hộ.
Các con số trong đoạn trên chỉ để minh họa văn phong. Bảng hệ số trong luận văn nên có các cột B, sai số chuẩn, β, t, p, VIF; theo chuẩn APA, giá trị p ghi đến ba chữ số thập phân và dùng "p < 0,001" thay cho "p = 0,000".
Sai lầm thường gặp khi chạy hồi quy
- Diễn giải β như B, hoặc ngược lại, khi viết phương trình hồi quy.
- Kết luận "X gây ra Y" từ dữ liệu khảo sát cắt ngang. Hồi quy cho thấy liên hệ, quan hệ nhân quả cần thiết kế nghiên cứu phù hợp.
- Bỏ qua kiểm tra giả định, chỉ báo cáo R² và p.
- Loại bớt quan sát để mô hình "đẹp" mà không có tiêu chí loại ngoại lai được xác định trước. Mọi việc loại quan sát phải có tiêu chí rõ ràng và được báo cáo.
Phân tích hồi quy online với ResearchSTAT
ResearchSTAT thực hiện phân tích hồi quy online với đầy đủ bảng tóm tắt mô hình, ANOVA, hệ số B, β, t, p, khoảng tin cậy, VIF, Durbin-Watson, các biểu đồ phần dư và cảnh báo tự động khi giả định có dấu hiệu bị vi phạm. Ở chế độ phân tích tự động, hệ thống tạo biến đại diện từ các thang đo, chạy hồi quy biến phụ thuộc theo các biến độc lập và đưa vào báo cáo tổng hợp cùng Cronbach's Alpha, EFA và tương quan. Kết quả được tính bởi bộ máy thống kê độc lập, kèm mô tả phương pháp để bạn đối chiếu.
Nếu mô hình của bạn có nhiều biến trung gian hoặc nhiều biến phụ thuộc, hãy cân nhắc chuyển sang SEM. Tham khảo bài CB-SEM và PLS-SEM.
Câu hỏi thường gặp
R² bao nhiêu là đủ?
Không có ngưỡng chung. Trong nghiên cứu hành vi dùng dữ liệu khảo sát, R² từ 0,2 - 0,5 là phổ biến. Điều quan trọng là mô hình có ý nghĩa, các giả định được đảm bảo và kết quả phù hợp với lý thuyết.
Biến nhân khẩu học có đưa vào hồi quy được không?
Được, dưới dạng biến kiểm soát. Biến định danh nhiều nhóm (nghề nghiệp, khu vực) cần chuyển thành biến giả (dummy), bỏ một nhóm làm nhóm tham chiếu.
Tài liệu tham khảo
- Hair, J. F., Black, W. C., Babin, B. J., & Anderson, R. E. (2019). Multivariate data analysis (8th ed.). Cengage.
- Field, A. (2018). Discovering statistics using IBM SPSS Statistics (5th ed.). SAGE.
- Durbin, J., & Watson, G. S. (1951). Testing for serial correlation in least squares regression II. Biometrika, 38(1/2), 159-177.
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.).