CFA (phân tích nhân tố khẳng định) và CB-SEM là hai bước tiếp theo sau EFA trong các nghiên cứu dùng AMOS. Trên ResearchSTAT, bạn dựng sơ đồ bằng kéo thả, ước lượng bằng phương pháp ML và nhận đủ các bảng như AMOS. Bài viết hướng dẫn thao tác và cách đọc từng chỉ số.
Các bước thực hiện trên ResearchSTAT
- Mở SEM → CB-SEM (kiểu AMOS), chọn bộ dữ liệu.
- Bấm Gợi ý từ dữ liệu để tạo biến tiềm ẩn từ các nhóm biến cùng tiền tố, hoặc thêm từng biến tiềm ẩn rồi kéo biến quan sát từ cột “Biến quan sát” thả vào.
- Với CFA: nối các biến tiềm ẩn bằng mũi tên hai chiều (hiệp phương sai). Với SEM: vẽ mũi tên một chiều theo giả thuyết.
- Bấm Ước lượng mô hình; kiểm tra nhận dạng được thực hiện tự động trước khi chạy.
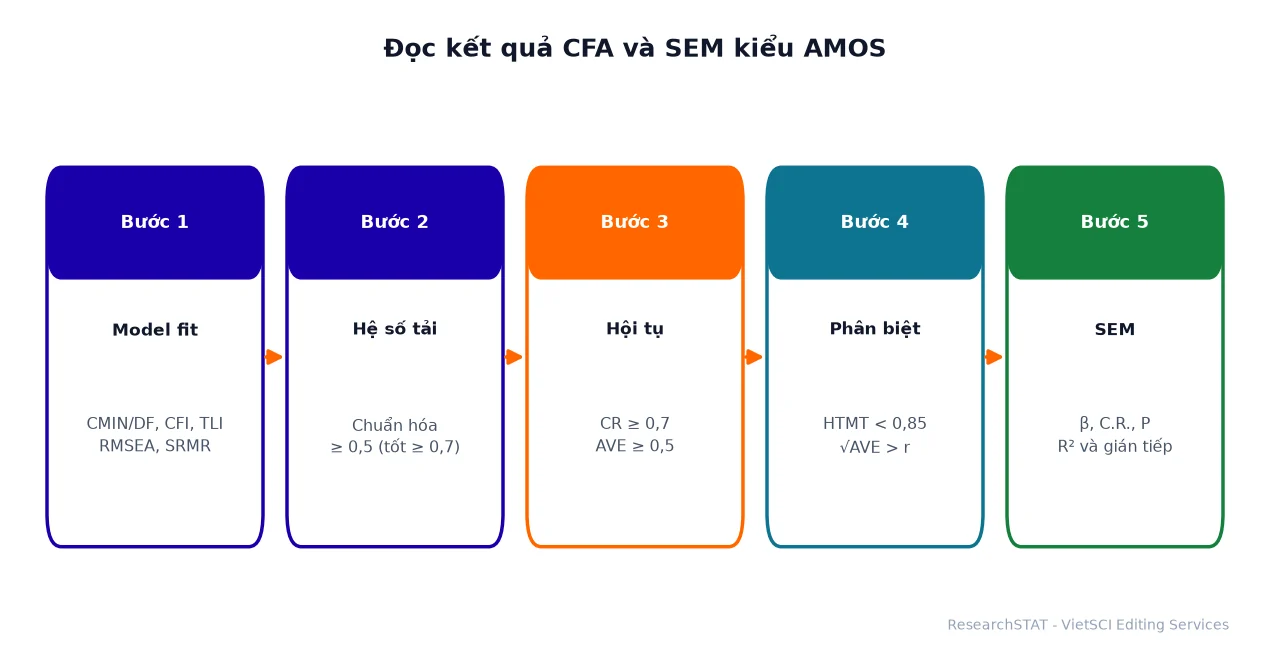
1. Chỉ số phù hợp mô hình (Model Fit)
| Chỉ số | Giá trị | Ngưỡng (Hu & Bentler, 1999; Hair và cộng sự, 2019) |
|---|---|---|
| CMIN/DF | 1.874 | < 3 tốt; < 5 chấp nhận |
| CFI | .962 | ≥ 0.9; tốt ≥ 0.95 |
| TLI | .954 | ≥ 0.9 |
| RMSEA | .047 | ≤ 0.06 tốt; ≤ 0.08 chấp nhận |
| SRMR | .038 | ≤ 0.08 |
Tất cả chỉ số đều đạt: mô hình đo lường phù hợp với dữ liệu. Nếu chưa đạt, xem các biến có hệ số tải thấp hoặc chỉ số điều chỉnh (Modification Indices) giữa các sai số cùng thang đo; chỉ nối sai số khi có lý do nội dung.
2. Hệ số tải chuẩn hóa và giá trị hội tụ
| Thang đo | Hệ số tải chuẩn hóa | CR | AVE | MSV |
|---|---|---|---|---|
| STC | .778 - .842 | .876 | .641 | .198 |
| CLD | .756 - .861 | .894 | .629 | .198 |
| SHL | .801 - .868 | .885 | .673 | .162 |
Hệ số tải chuẩn hóa ≥ 0,5 (tốt từ 0,7), CR ≥ 0,7 và AVE ≥ 0,5 (Fornell & Larcker, 1981; Hair và cộng sự, 2019): các thang đo đạt độ tin cậy và giá trị hội tụ.
3. Giá trị phân biệt
Hai cách đánh giá: MSV < AVE và căn bậc hai AVE lớn hơn tương quan giữa các khái niệm (Fornell-Larcker), hoặc HTMT < 0,85 (Henseler và cộng sự, 2015). ResearchSTAT tính cả hai bảng; trong ví dụ HTMT lớn nhất bằng 0,512 nên đạt.
4. Kết quả mô hình cấu trúc (SEM)
| Đường dẫn | Estimate (β) | S.E. | C.R. | P |
|---|---|---|---|---|
| SHL <--- STC | .412 | .051 | 8.217 | *** |
| SHL <--- CLD | .356 | .048 | 7.103 | *** |
| SHL <--- GCA | .094 | .045 | 1.928 | .054 |
P = *** nghĩa là p < 0,001. Hai giả thuyết STC → SHL, CLD → SHL được ủng hộ; GCA → SHL có p = 0,054 > 0,05 nên bị bác bỏ. Tác động gián tiếp (nếu có biến trung gian) được kiểm định bằng bootstrap với khoảng tin cậy 95%.
Kết quả CFA cho thấy mô hình đo lường phù hợp với dữ liệu (CMIN/DF = 1,874; CFI = 0,962; TLI = 0,954; RMSEA = 0,047; SRMR = 0,038). Các thang đo có CR từ 0,876 đến 0,894 và AVE từ 0,629 đến 0,673, đạt độ tin cậy và giá trị hội tụ; HTMT đều nhỏ hơn 0,85. Kết quả SEM cho thấy sự tin cậy (β = 0,412; p < 0,001) và chất lượng dịch vụ (β = 0,356; p < 0,001) tác động cùng chiều đến sự hài lòng.
ResearchSTAT có phải là AMOS không?
Không. ResearchSTAT dùng bộ máy ước lượng CB-SEM độc lập (ML) và trình bày kết quả theo bố cục, thuật ngữ quen thuộc của AMOS. Ghi đúng công cụ đã dùng trong luận văn.
Cỡ mẫu bao nhiêu thì chạy CB-SEM được?
Tối thiểu khoảng 200 và nên gấp 5-10 lần số tham số ước lượng. Xem bài cách tính cỡ mẫu trên blog.